题目描述
给定一个未排序的整数数组 nums ,找出数字连续的最长序列(不要求序列元素在原数组中连续)的长度。
请你设计并实现时间复杂度为 O(n) 的算法解决此问题。
示例 1:
输入:nums = [100,4,200,1,3,2]
输出:4
解释:最长数字连续序列是 [1, 2, 3, 4]。它的长度为 4。
示例 2:
输入:nums = [0,3,7,2,5,8,4,6,0,1]
输出:9
示例 3:
输入:nums = [1,0,1,2]
输出:3
提示:
0 <= nums.length <= 10^5-10^9 <= nums[i] <= 10^9
分析1
我们可以将这里的的数字分类,分为三类:
- 头:该数字没有前置数字
- 中:该数字存在前置和后续数字
- 尾:该数字没有后续数字
我们这的任务就是将所有的头节点找到(假设为 x ),然后从头节点找到下一个 x+1 、x+2 ... x+n ,直到找到尾节点(没有 x+m 的数字了),这就成为了一个完整的连续序列了。这样就可以与之前找的序列的长度进行比较,找到最长的那个就是我们需要的最后答案。
解答1
class Solution {
    public int longestConsecutive(int[] nums) {
        Set<Integer> set = new HashSet<>();
        int res = 0;

        // 将数据添加到set里进行去重
        for(int n:nums)
            set.add(n);

        // 遍历整个set
        for(int num:set){
            // 检测当前数字是不是最前面的数字
            if(!set.contains(num-1)){
                int currentNum = num;
                int currentStreak = 1;  // 记录当前长度

                // 一直判断是否存在下一个连续的数字
                while(set.contains(currentNum+1)){
                    currentNum = currentNum + 1;
                    currentStreak += 1;
                }

                // 判断完成,得到当前最长
                res = res > currentStreak ? res : currentStreak;

            }
        }
        return res;
    }
}
复杂度分析
- 时间复杂度:将数据添加到set里,复杂度为 O(n) ,遍历整个set复杂度为 O(m),其中
m为不同数字的个数m <= n,只有连续序列的“起点”才会进入while循环,故总体时间复杂度为 O(n)。 - 空间复杂度:
HashSet最多存储n个不同数字,因此需要 O(n) 的额外空间。
为什么要用 HashSet ?
HashSet可以去重,保证每个数字唯一。- 底层是哈希表,contains、add、remove 的平均时间复杂度都是 O(1)。这样才能保证不管序列有多长,我们“找下一个数”和“判断前一个数”的操作都是瞬间完成的。
- 如果用数组会发生什么?数组的
contains操作的时间复杂度是 O(n) ,这样就会导致整个总时间复杂度变成的 O(n^2) 。
为什么时间复杂度是 O(N)?
这里的可以看到 for 循环里还有一个 while 循环,可能会想这个是不是 O(n^2) 的时间复杂度。但实际上只有外层 for 循环遍历的是去重后的 set,执行了 m 次(m <= n),而 while 循环只会对每个连续序列的“起点”执行,而且每个数字在 while 里最多被访问一次。
下面举个例子来说明为什么每个数字在 while 里最多被访问一次:
假设数组是 nums = [1, 2, 3, 4, 5]。我们假设 set 的遍历顺序恰好是 1, 2, 3, 4, 5。实际上 HashSet 的遍历顺序不确定,但无论顺序如何,每个数字最多被 while 访问一次,结论不变。
执行过程拆解:
第一步:外层 for 循环遍历到 1
-
判断:num - 1 也就是 0 在集合里吗?不在。
-
所以 1 是起点,进入 while 循环。
-
while 循环内部:
- 检查 2 在不在?在。currentNum 变成 2。
- 检查 3 在不在?在。currentNum 变成 3。
- 检查 4 在不在?在。currentNum 变成 4。
- 检查 5 在不在?在。currentNum 变成 5。
- 检查 6 在不在?不在。退出 while。
-
这一次 while 循环,检查了 2, 3, 4, 5。总共执行了 4 次。
第二步:外层 for 循环遍历到 2
- 判断:num - 1 也就是 1 在集合里吗?在!
- 所以 2 不是起点。直接跳过,根本不进入 while 循环。
第三步:外层 for 循环遍历到 3
- 判断:num - 1 也就是 2 在集合里吗?在!
- 直接跳过。
第四步、第五步:遍历到 4 和 5
- 同理,前面的数字都在,全部直接跳过。
2, 3, 4, 5 这四个数字,只在 1 触发的那个 while 循环中被访问了一次。 当外层 for 循环后来遍历到它们时,因为前面有数字,它们被 if (!set.contains(num - 1)) 这个条件直接拦截了,根本没有机会触发自己的 while 循环。
所以最后计算时间复杂度时,就是 O(n) 。
分析2
这是在该题的leetcode的评论区看到的,解法思路从 #200 岛屿数量 而来。原题主要考的是BFS/DFS,一个二维的地图,借助其思路,可以这样进行假设:将我们要求的数假设为一维的地图,我们先登上其中一块岛屿(选一个数),然后观察左右有没有相邻的岛屿(连续的数字),分别向两边走,然后记录走的总长度,走过的就“淹没”(从集合中删除),下次不再走。
解答2
class Solution {
    public int longestConsecutive(int[] nums) {
        Set<Integer> set = new HashSet<>();
        int res = 0;

        // 将数据添加到set里进行去重
        for(int n:nums)
            set.add(n);

        // 遍历整个数组(扫描整片海域)
        for(int num:nums){
            int currentStreak = 0;

            // 如果这个数字还在集合里(说明它还没被探索过,是一块新岛屿的入口)
            if(set.contains(num)){
                set.remove(num);   // 访问过后就“淹没”
                currentStreak = 1;

                // 向左探索
                int temp = num - 1;
                while(set.contains(temp)){
                    set.remove(temp);
                    currentStreak++;
                    temp--; // 继续左走
                }

                // 向右探索
                int temp2 = num + 1;
                while(set.contains(temp2)){
                    set.remove(temp2);
                    currentStreak++;
                    temp2++; // 继续右走
                }

                // 更新最长岛屿长度
                res = res > currentStreak ? res : currentStreak;
            }
        }
        return res;
    }
}
复杂度分析:
- 时间复杂度:将数据添加到set里,复杂度为 O(n) ,遍历整个数组复杂度为 O(n) ,每个数字一旦被
set.remove(num)移除,之后就不会再进入扩展分支。while向左、向右扩展时,也会把访问过的数字从集合中移除。因此每个数字最多被加入一次、被移除一次、在扩展中被访问一次。所有while循环的总执行次数不超过 n,所以整体仍然是 O(n) 。 - 空间复杂度:
HashSet最多存储n个不同数字,因此需要 O(n) 的额外空间。
为什么遍历 nums 而不是遍历 set?
为什么我们要在
// 遍历整个数组(扫描整片海域)
        for(int num:nums){
遍历数组而不是直接遍历 set 呢?如果遍历了 set 那不就不用下面再判断是否存在于 set 了吗?
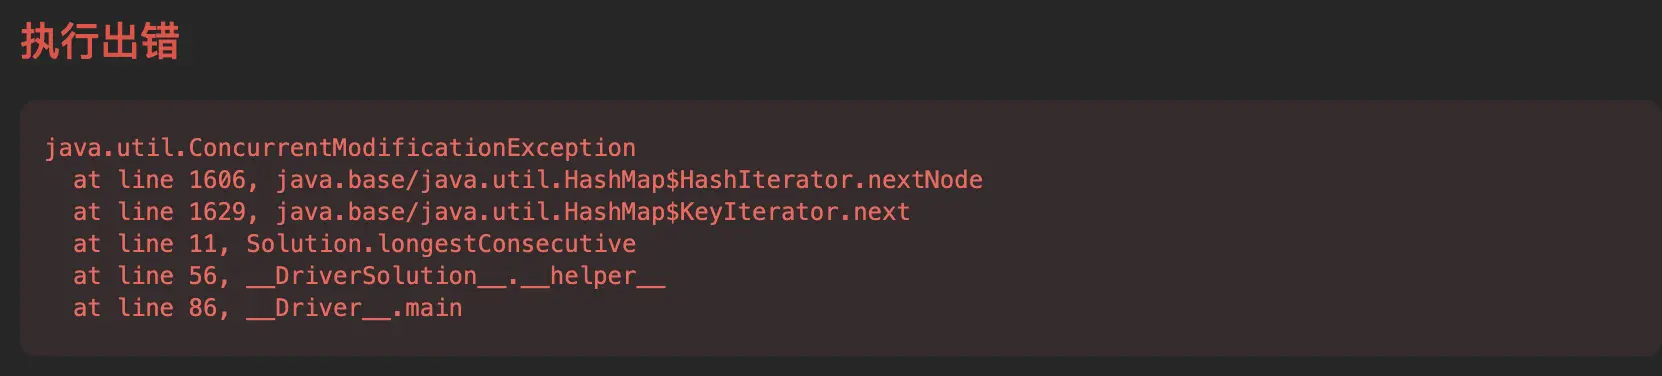
因为在 Java 中,如果你使用增强 for 循环(for (int num : set)),编译器会把它转换成使用 Iterator(迭代器) 来遍历。
Java 的集合类(如 HashSet、ArrayList)都实现了 Fail-Fast 机制。这意味着:
迭代器在遍历时,内部会维护一个版本号(modCount,修改次数)。
每次调用 iterator.next() 时,都会检查当前的 modCount 是否等于迭代器刚创建时的 expectedModCount。
如果你在循环体内直接调用了 set.remove(),集合的 modCount 就会加 1。
下一次循环迭代器调用 next() 时,发现 modCount != expectedModCount,就会立刻抛出 ConcurrentModificationException,程序直接崩溃。
所以千万不能像下面这样写
for (int num : set) { // 底层使用 Iterator
    if (set.contains(num)) {
        set.remove(num); // 抛出 ConcurrentModificationException!
    }
}
为什么遍历 nums 就是安全的?
nums 是一个普通的数组(int[])。
当使用 for (int num : nums) 遍历数组时,底层并不是迭代器,而是普通的 for (int i = 0; i < nums.length; i++) 索引遍历。数组没有 modCount 检查机制。